./run fine-tuning-estrazione-knowledge-graph-lezione-dati
Relation F1 a 0.38: quando la lezione non era il modello, ma i dati
Diario tecnico di un fine-tuning: LoRA su un modello da 27B per estrarre knowledge graph da documenti disordinati. La svolta non è stata un modello più…
- status
- alive
- updated
- 2026-09-18
- tags
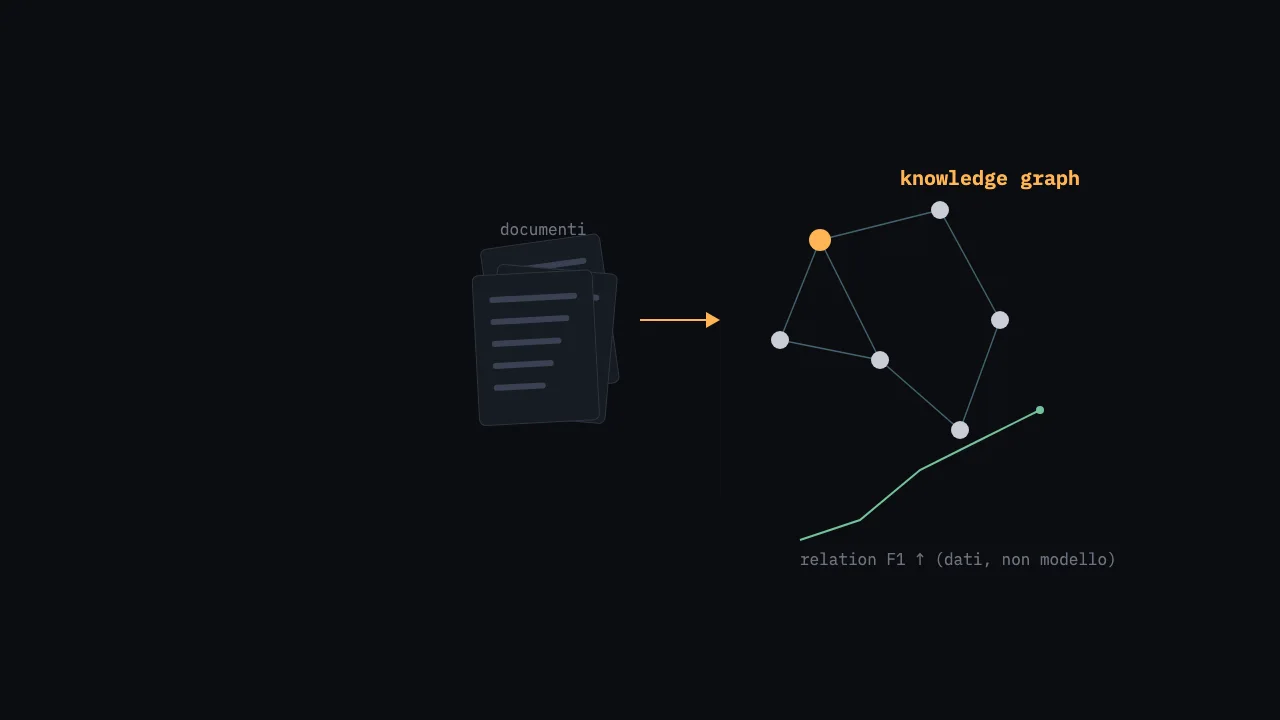
Questo è il progetto di cui posso raccontare meno nei dettagli, e va bene così: il dominio resta fuori. Ma la lezione tecnica la posso spiegare tutta, e vale per chiunque lavori con gli LLM. In una riga: prima di cambiare modello, guarda i dati.
Il compito
Testo lungo, sporco, in italiano → un knowledge graph in JSON. Ogni documento è spezzato in segmenti; il target di ognuno è un oggetto con questa forma:
entities: lista di{name, type}— nodi tipati con nome canonicorelations: lista di{subject, predicate, object, evidence_text}— archi diretti tipati, più la citazione testuale che li prova
Con un vincolo duro imposto nello schema: subject e object devono essere esattamente un name presente in entities — il grafo deve essere internamente coerente. Il vocabolario è chiuso: un enum fisso di tipi entità e predicati.
Il modello e il fine-tuning
Parto da un modello base denso da ~27B, e faccio LoRA/SFT (PEFT + TRL). Nessun addestramento da zero: aggiorno lo 0.58% dei parametri.
mods7 = ["q_proj","k_proj","v_proj","o_proj","gate_proj","up_proj","down_proj"]
target = r".*language_model.*\.(" + "|".join(mods7) + r")$"  # salta la vision tower
LoraConfig(r=32, lora_alpha=64, lora_dropout=0.1,
           target_modules=target, bias="none", task_type="CAUSAL_LM")
# bf16, grad-checkpointing, lr=2e-4 cosine, micro_bs=1 x grad_accum=8,
# cutoff 16384 token, ~4 epoche, best su eval_loss + early stopping
Il servizio è vLLM con multi-LoRA: il base resta residente una volta, gli adapter si attaccano come moduli nominati — più fine-tuning condividono lo stesso base. Gira su HPC on-prem (2 GPU classe H200, Slurm), bindato solo su loopback, tracciato in MLflow — dove finiscono solo aggregati, mai testo grezzo o generazioni.
La svolta (che è tutto il progetto)
La v1 l’ho addestrata, congelata e messa in produzione. Funzionava. E poi ho fatto l’errore classico: pensare che per migliorare servisse un modello più grande.
Sbagliato. Guardando dove sbagliava, il quadro era netto:
- Entità: F1 ~0.68-0.71, decente.
- Relazioni: F1 ~0.38-0.41, debole.
E la debolezza era concentrata nella coda rara: i predicati con meno di 500 esempi segnavano ~0.00, con una correlazione chiara tra rarità e F1. La causa radice, quando l’ho trovata, era imbarazzante e istruttiva: lo schema ricco era stato aggiunto dopo che il corpus era già annotato. Documenti che erano esempi da manuale di una relazione nuova ne estraevano ~0, perché a mancare non era il testo — era lo strato di annotazione.
Quindi la leva non era “più documenti” (provato: rende ~0). Era ri-annotare il testo esistente sotto lo schema nuovo.
La v2 è ingegneria dei dati, non del modello
Tre mosse, tutte quantificate:
- Allargamento schema — nuovi predicati enumerati dai dati, mai inventati.
- Ri-annotazione fine — stesso testo, etichette più nette (rimappare il volume di un catch-all grossolano sui figli direzionali precisi).
- Densificazione della coda — predicati prima vuoti riempiti con ri-annotazione delta su ~1.800 chunk candidati.
E una disciplina che mi è piaciuta molto: learnable vs measurable come vincolo di split. Il test set è scelto da un selettore greedy deterministico che deve coprire ogni predicato prioritario con ≥30 istanze di test (misurabilità) senza far scendere nessun predicato sotto le 50 in training (apprendibilità). Dove i due obiettivi confliggono, il predicato è dichiarato “apprendibile ma non misurabile su questo split” — tenuto e addestrato, escluso dalla metrica. Non buttato.
Misurare onestamente
- Micro P/R/F1 separati per entità e relazioni, con matching greedy uno-a-uno.
- Scoring alias-aware: dà credito se la forma corrisponde a qualsiasi variante nota dell’entità gold, non solo al nome canonico — separa i veri errori dalla semplice varianza di naming (relation F1 0.38→0.41).
- Due audit oltre l’F1: campiono i falsi positivi e controllo se entrambi gli estremi e la citazione compaiono davvero nel chunk (≈47% degli “errori” erano estrazioni corrette mancanti dal gold — incompletezza dell’annotazione, non del modello); e verifico che l’
evidence_textdei veri positivi sia verbatim nel testo (~87.5%, un check anti-allucinazione).
Cosa ho imparato
Il base era già grande, e le sue entità erano forti; scalarlo non avrebbe fabbricato relazioni che il gold non conteneva. Gli audit lo dicevano chiaro: una fetta grossa dei “falsi positivi” erano estrazioni giuste assenti dall’annotazione. È lo stesso pattern del record pubblico (TACRED→Re-TACRED, +16 F1 solo pulendo il gold, architettura invariata).
Poco eccitante da mettere in una slide. Ma è quello che ha spostato l’ago: in un progetto di estrazione, il prodotto non è il modello — è il dataset curato che ci sta dietro. Il modello è sostituibile. Il gold standard costruito bene, no.
Aggiornamenti
2026-09La parità è un risultato, non un fallimento
Ho chiuso la v2 con due adapter LoRA sullo stesso modello base da 27B — uno relazionale, uno per la timeline — e la certificazione onesta dice parità, non sorpasso: relazioni 0.296 contro 0.281 della versione precedente, entità 0.478 contro 0.484, con gli intervalli di confidenza bootstrap appaiati che contengono lo zero su entrambi gli assi, ma su uno spazio di etichette più duro (31 predicati invece di 24) e con una capability in più che prima non esisteva. Il pezzo che ha spostato l’ago non è stato un re-train ma lo stack di serving: generazione vincolata a schema con cap sugli elementi, grounding alias-aware e un filtro sulle signature dei ruoli che scarta il 12,2% delle relazioni incoerenti per tipo — e il solo grounding alias-aware ha chiuso il gap sulle entità (+0.044 F1) che avevo diagnosticato come deficit di recall da training. La cosa controintuitiva è che lo stesso stack applicato al modello vecchio lo peggiora (−0.081 F1), perché cura una degenerazione che solo il nuovo produce: il confronto onesto non è “entrambi sotto serving” ma “ciascuno alla configurazione con cui spedisce davvero”. Per avere numeri robusti ho fatto una k-fold document-level a 5 fold, leakage-safe: 0.287 ± 0.009 sulle relazioni, 0.510 ± 0.012 sulle entità, 0.353 ± 0.017 sugli eventi; deviazioni strette, e lo split singolo di deployment risulta rappresentativo sulle relazioni e persino pessimista sulle entità. La decomposizione degli errori ha poi chiuso il cerchio della lezione precedente sui dati: circa l’87% dei falsi negativi ha entrambi gli estremi visibili nel segmento, quindi stavolta il tetto è il modello, non l’annotazione — e la coda rara resta debole ma pesa il 15% delle istanze, mentre l’aggregato è fermo perché i predicati di testa stanno a ~0.34. Artefatti congelati in sola lettura con checksum e manifest; il rilascio effettivo è una decisione di chi possiede il sistema, non mia.
Per riservatezza, dominio e contenuti restano fuori dal diario. Racconto il metodo, non la materia.
grep -rl 'stesso filo' ~/lab
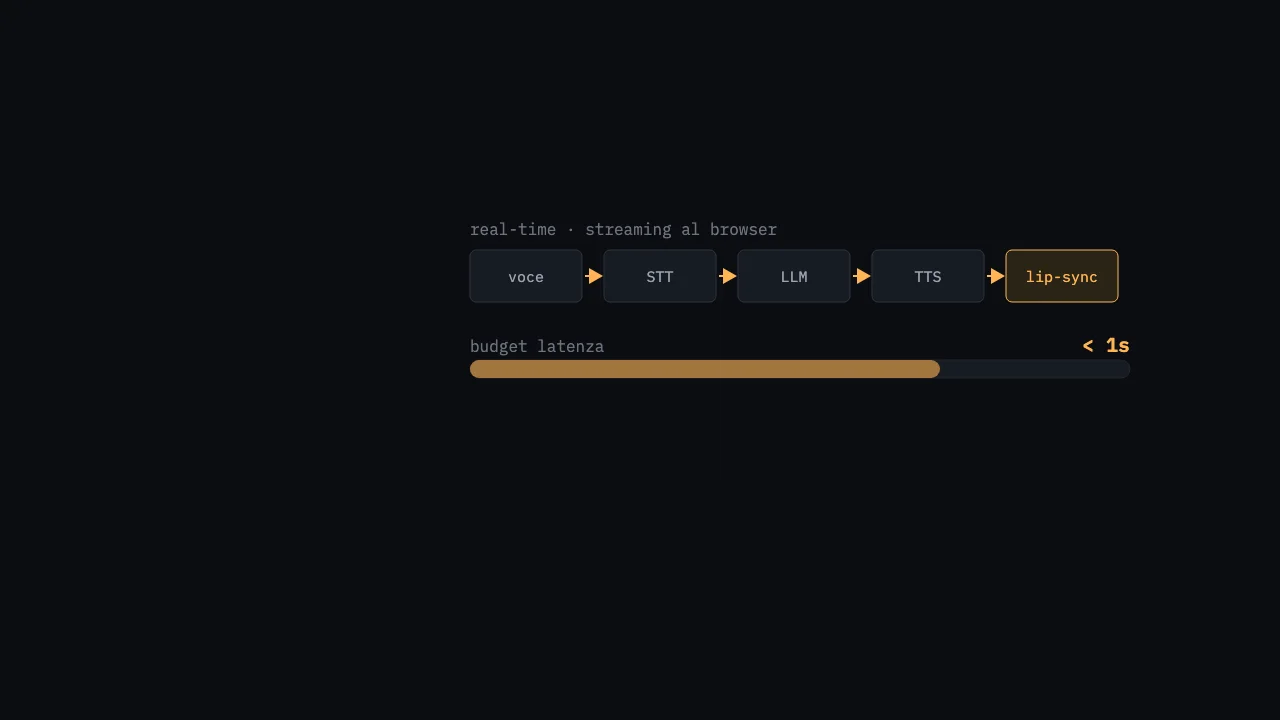
L'avatar che parla prima di muovere le labbra
Diario di un avatar AI conversazionale in tempo reale: STT, LLM, TTS e lip-sync su GPU. La decisione dura è stata sganciare l'audio dal video.
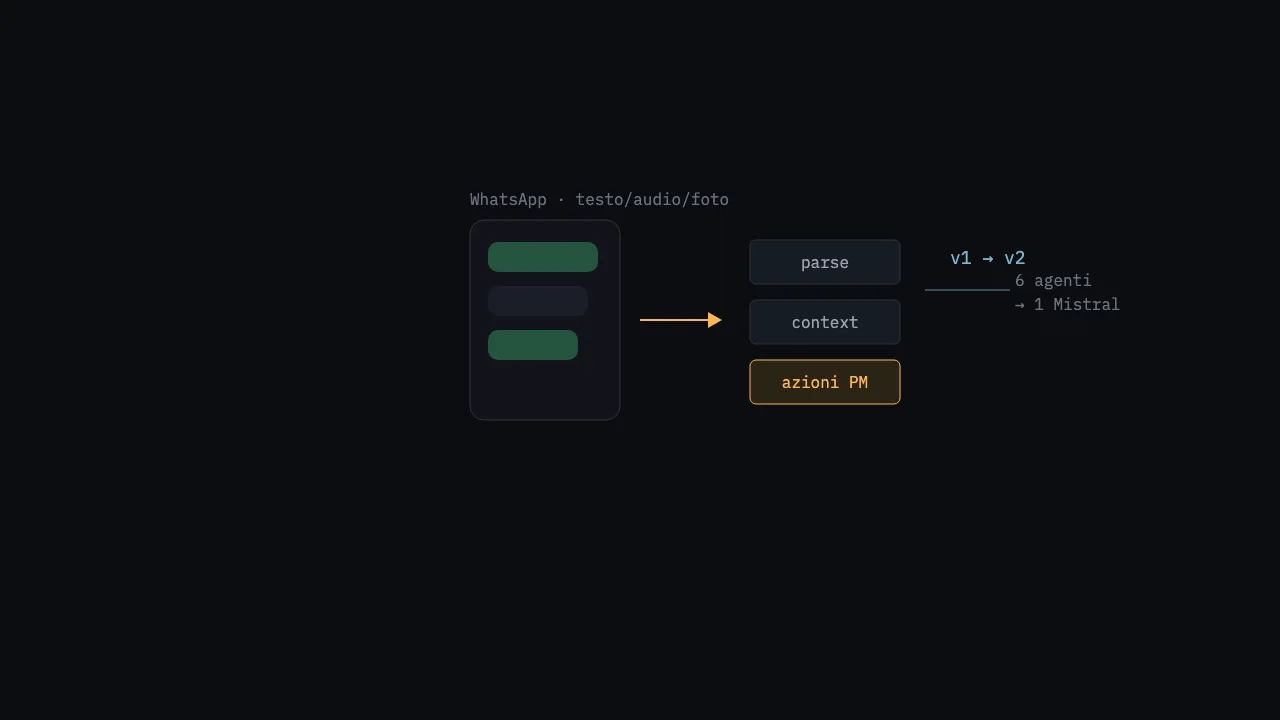
Pragma, due volte: ho buttato sei agenti e due database, e ci ho guadagnato una feature che pesa 1
Ho ricostruito da zero un assistente di project management via WhatsApp per la PA: da sei agenti e tre database a uno solo. Diario su quale complessità si è…
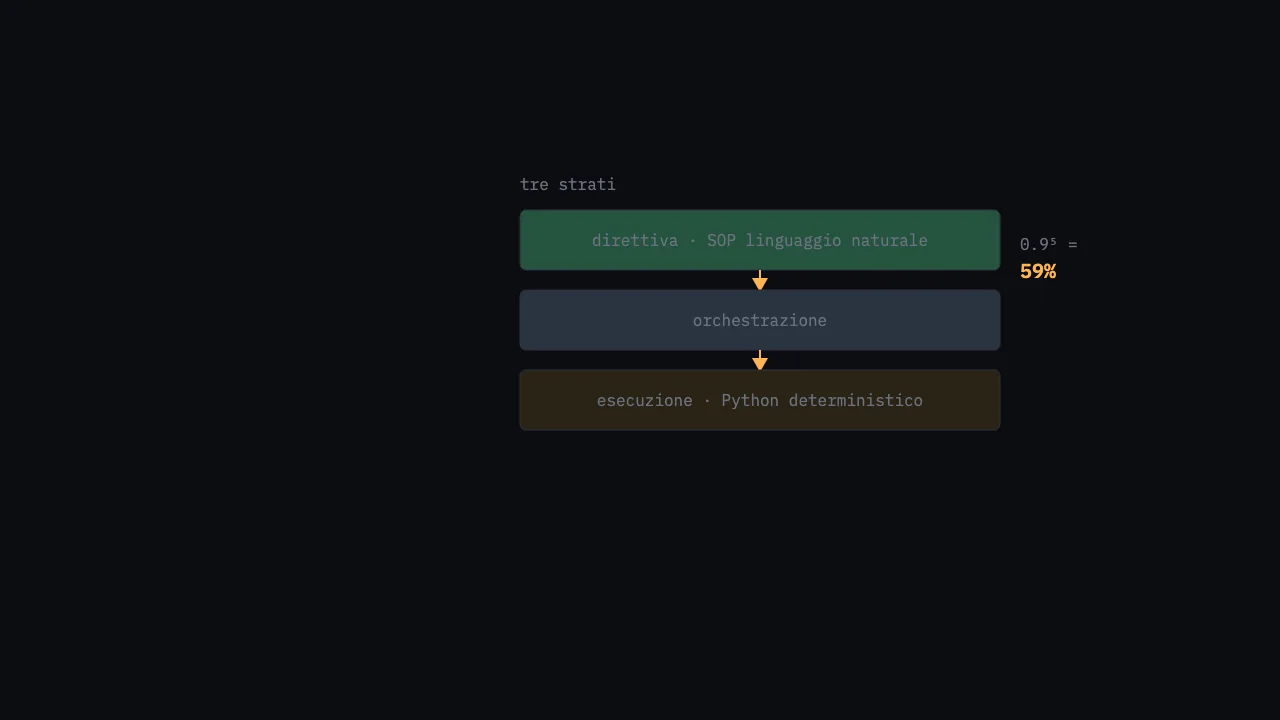
Il 59%: perché ho smesso di lasciar fare tutto all'LLM
Diario di uno scaffold multi-agente su Agno: tre strati direttiva/orchestrazione/esecuzione, SOP in linguaggio naturale sopra, Python deterministico sotto…