./run dipartimento-it-agenti-che-dibattono
Il dipartimento IT che litiga da solo: tre strati e un umano nel loop
Un dipartimento IT fatto di agenti AI — NOC, SOC, SRE, Architecture Board — che osservano un cluster k8s, si confutano a vicenda e preparano decisioni per un…
- status
- wip
- project
- IT-department
- updated
- 2026-09-28
- tags
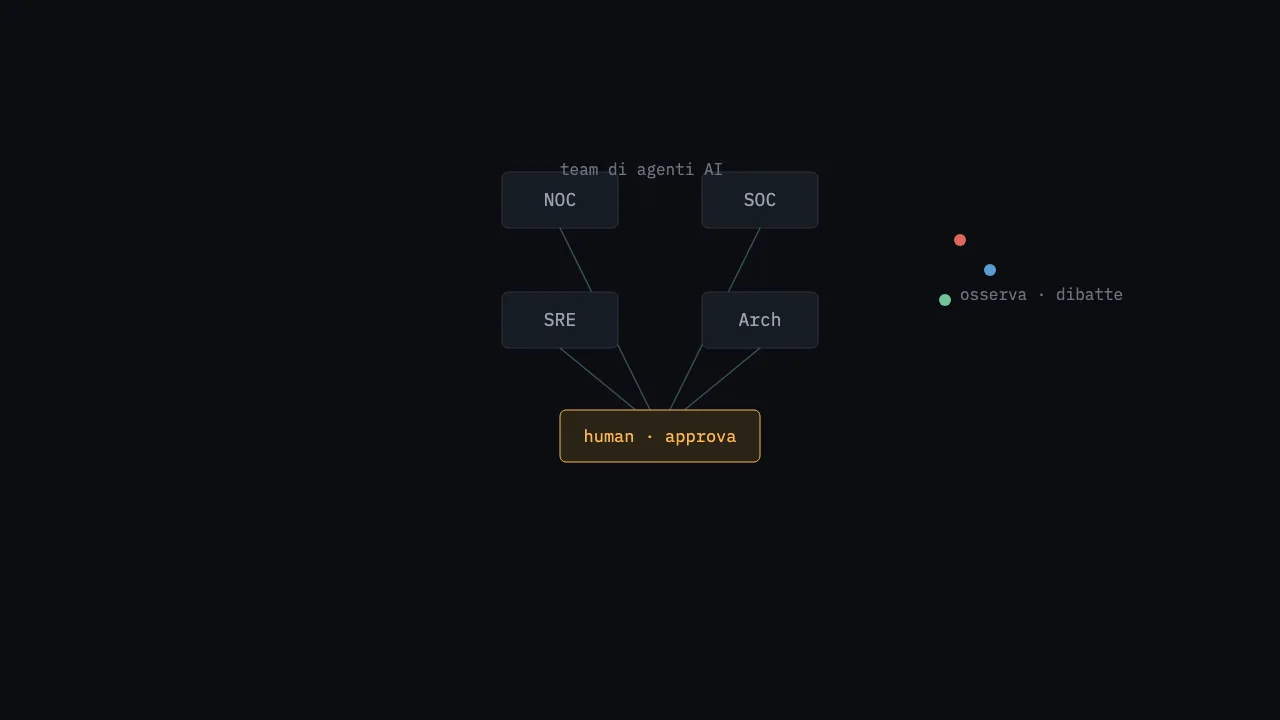
C’è un momento preciso in cui un operatore singolo capisce di essere troppo piccolo per i tool enterprise e troppo grande per gestire tutto a mano: quando davanti a un alert “OSD lento” deve decidere da solo se comprare un disco, spostare un carico o non fare niente — e non ha nessuno con cui litigare prima di decidere. IT-Department nasce da lì: un dipartimento IT fatto di agenti AI che si confutano a vicenda, così l’umano riceve una decisione già dibattuta invece di un allarme grezzo.
L’idea: non uno script, un organigramma
Il sistema gestisce un cluster Kubernetes self-hosted ibrido — worker e storage Ceph su bare metal, control-plane su VM Hetzner e servizi dentro e fuori dal cluster. Ma il punto non è cosa gestisce — è come pensa. Invece di un unico agente onnisciente, ho modellato sei team con mandati distinti:
- NOC — occhi e orecchie: metriche, health check, primo intervento.
- SOC/CERT — sicurezza: CVE, hardening, certificati, incident response.
- SRE — capacity planning, Ceph, DR, draft di ticket tecnici.
- Architecture Board — il tavolo delle decisioni: fa il devil’s advocate su ogni proposta.
- Procurement — scouting del mercato hardware.
- Project Office — migrazioni e change management.
La regola che tiene insieme tutto è una sola: i team si alimentano e si contraddicono. Se il NOC dice “serve più RAM”, l’SRE può ribattere “no, il collo di bottiglia sono i dischi, guarda le latency di Ceph”. Il Board pesa entrambe le posizioni. L’umano decide informato.
Architettura: tre strati, una separazione netta
La spina dorsale è un modello a tre strati, ripetuto ossessivamente in ogni file di istruzioni:
- Layer 1 — Directive (cosa fare): SOP in Markdown in
directives/. Sono istruzioni in linguaggio naturale, come le daresti a un dipendente di medio livello. Ogni team ha la sua. - Layer 2 — Orchestration (decidere): l’LLM. Legge la directive, chiama gli strumenti giusti nell’ordine giusto, gestisce gli errori. È la colla tra intento ed esecuzione.
- Layer 3 — Execution (fare): script Python deterministici in
execution/. API, parsing, kubectl, file. Affidabili, testabili, veloci.
Il razionale è scritto nero su bianco nel CLAUDE.md, ed è la frase che giustifica l’intera struttura:
Se fai tutto tu, gli errori si moltiplicano. 90% di accuratezza per step = 59% di successo su 5 step. La soluzione è spingere la complessità dentro codice deterministico.
Tradotto: l’LLM non deve fare il lavoro, deve decidere quale script deterministico invocare. Un collect_ceph_status.py che parsa ceph osd perf non sbaglia una volta su dieci come farebbe un modello che “guarda” l’output. L’intelligenza si aggiunge sopra i dati deterministici, non li sostituisce.
Come si sveglia un umano: due livelli e una macchina a stati
Qui sta il cuore. Non tutto merita di svegliare l’operatore. L’orchestrator distingue due classi di azione:
- L1 — autonomo: manutenzione ordinaria che il sistema fa da solo. Esempio reale dal codice: se in namespace Velero ci sono più di 10 pod
Succeeded, li ripulisce senza chiedere. - L2 — richiede autorizzazione: tutto ciò che è distruttivo o costoso. Qui il sistema non agisce: prepara e segnala.
E c’è una scelta che dice tutto sulla filosofia — i pod in CrashLoopBackOff vengono rilevati e loggati, mai riavviati in automatico:
if "CrashLoopBackOff" in line:
    # log only, non restart automatico
    crashloop_pods.append({"namespace": ..., "name": ..., "restarts": restarts})
Un pod che crasha 2400 volte non è un problema di riavvio: è un sintomo. Riavviarlo in automatico nasconderebbe la malattia. Meglio un alert L2.
Ma il pezzo che mi rende più orgoglioso è la macchina a stati delle decisioni (decision_manager.py). Ogni proposta del Board diventa un file JSON con un lifecycle esplicito:
NEW → NOTIFIED → SEEN → ACCEPTED/REJECTED → IMPLEMENTED
NOTIFIED → (5 giorni senza SEEN) → EXPIRED → re-analisi → NEW
Le transizioni sono validate a monte — non puoi saltare da NEW a IMPLEMENTED:
valid_transitions = {
    "NEW":      ["NOTIFIED"],
    "NOTIFIED": ["SEEN", "EXPIRED"],
    "SEEN":     ["ACCEPTED", "REJECTED"],
    "ACCEPTED": ["IMPLEMENTED"],
    "REJECTED": [], "IMPLEMENTED": [],
    "EXPIRED":  ["NEW"],
}
Il dettaglio elegante è EXPIRED → NEW. Se una decisione resta 5 giorni senza che l’umano la guardi, non scade nel silenzio: viene ri-analizzata con i dati freschi e ri-proposta, con un refresh_count che cresce. Il sistema insiste, ma non decide mai al posto tuo. È l’opposto dell’alert-fatigue: invece di 200 notifiche identiche, una decisione che si ripresenta più informata.
Il gotcha onesto: il dibattito non è (ancora) codice
Ecco la parte che un README venderebbe diversamente. La documentazione dice: “Orchestrazione: AGNO framework per team multi-agent con ruoli e collaborazione”. Ho fatto grep -rn agno su tutto il repo. Zero import. Zero Agent(), zero Team().
Il framework multi-agente, oggi, è aspirazionale. Il dibattito tra NOC e SRE non avviene tra due processi Python che si scambiano messaggi: avviene dentro un LLM che, leggendo le directive dei vari team come persona, gioca entrambi i ruoli e produce un Decision Record strutturato. Il “confronto” è un pattern di prompt orchestration, non un’architettura di agenti concorrenti.
Funziona? Sì, sorprendentemente bene — perché la sostanza vera sta negli script deterministici (quelli esistono e girano) e nella macchina a stati (quella esiste e valida). Il layer AGNO è la ciliegina che formalizzerà i ruoli, ma la torta regge già senza. È esattamente il tipo di drift README/realtà che va detto ad alta voce: il valore non è nel framework citato, è nel fatto che i dati sono affidabili e l’umano resta nel loop.
Come va: operativo per davvero
Non è un POC da slide. Le fasi 0–4 sono completate e il dipartimento produce output reali. Un ciclo recente ha tirato fuori, tra le altre cose:
- NOC/SRE: 7 CRITICAL + 8 WARNING su 7 nodi; un nodo con storage Ceph ~19× più lento di un altro (root cause: HDD sotto stress I/O, non CPU/RAM); un control plane a 2 vCPU saturi al 100%; un worker con 283 pod, il 55% del cluster.
- Capacity: ~120 PVC, ~5TB usati su ~43TB (12%) — nessun panico storage, il collo di bottiglia è la latenza, non lo spazio.
- SOC: 6 CRITICAL e 124 WARNING (SSL flexible, niente fail2ban sui bare metal, decine di record DNS con IP origine esposto), a fronte di certificati TLS tutti validi.
Ogni finding è confluito in uno dei 4 Decision Record P0/P1 che aspettano — pazientemente, con il loro refresh_count — la mia decisione. L’automazione continua (agent di raccolta via cron ogni 5 minuti, alerting) è la fase incrementale successiva.
Cosa ho imparato
- La reliability non viene dall’LLM, viene da dove lo togli. Ogni volta che ho spostato logica dal ragionamento del modello a uno script deterministico, il sistema è diventato più prevedibile. Il modello deve scegliere, non calcolare.
- Il dibattito serve più della risposta. Costringere il sistema a produrre sempre un’opzione “non fare nulla”, un devil’s advocate e una dissenting opinion ha cambiato la qualità delle raccomandazioni più di qualsiasi prompt “sii intelligente”.
- Far scadere una decisione è un feature, non un bug.
EXPIRED → NEWè la differenza tra un sistema che ti tormenta e uno che ti ricorda le cose al momento giusto, con dati aggiornati. - Scrivi il drift a voce alta. Dire “AGNO è documentato ma non ancora implementato” costa un attimo di orgoglio e compra tutta la credibilità del resto.
Il sistema pensa, si confuta, e prepara. Ma l’ultima parola resta dov’è giusto che sia: sull’operatore.
Aggiornamenti
2026-09Backup, dischi e patch: la settimana delle cose silenziose
Questa settimana il dipartimento non ha dibattuto. Ha rimesso in piedi pezzi che si erano rotti in silenzio. La scoperta peggiore: da quattro domeniche l’autopatch di WordPress annullava gli aggiornamenti di siti perfettamente sani.
- Smoke test dell’autopatch — chiamava
/wp-login.phpsul Service senza headerHoste seguiva i redirect. I siti multisite e quelli conWP_HOMErispondevano con un 302 o una pagina vuota, e tre upgrade venivano annullati ogni settimana. Adessowp_core_autopatch.pylegge l’host canonico daWORDPRESS_CONFIG_EXTRA, rifiuta i redirect e segnala ogni 3xx con il suoLocation. Ho aggiunto ancheNOTIFY=0e--self-test. Un giro inDRY_RUNha dato 7/7 siti sani. - Velero in git — ho esportato gli schedule dal cluster in
k8s/velero/schedules.yaml, che ora fa da riferimento. Dieci namespace con PVC non avevano un backup giornaliero, posta compresa: se si rompeva, rischiavo di perdere fino a 7 giorni di mail. Ora sono coperti. - Report di trivy fuori dai backup — circa 644 SBOMReport rigenerabili finivano in ogni LIST notturno di Velero. Per un control plane da 2 vCPU e 8 GB era carico sprecato.
- Immagine
mcmorta — il monitor dei dischi MinIO era fermo inImagePullBackOff: i repominio/*su Docker Hub non ci sono più e quay rispondeUNAUTHORIZED. L’ho fissato per digest subitnamilegacy/minio-client, conMC_CONFIG_DIR=/tmp/.mcperché gira come utente non root. - SMART per i dischi Ceph — ho spento il modulo
devicehealthdi Ceph: ogni notte bloccava quattro OSD, che poi venivano riavviati dalla liveness probe. Al suo posto c’è un DaemonSetsmartctl-exporterche legge 6 dischi su 3 nodi ogni 5 minuti. Manda alert critici per settori riallocati o pendenti, errori CRC in crescita e temperatura sopra i 50 °C.
args:
- --smartctl.device=/dev/sda
- --smartctl.device=/dev/sdb
- --no-smartctl.scan        # mai toccare i device rbd/nbd
- --smartctl.interval=300s
Resta aperto un punto: il client MinIO punta a un’immagine congelata. Va spostato su una copia nel registry interno, che ancora non esiste.
2026-09Tutto verde, niente funzionava
Il filone di questi due mesi è stato uno solo: componenti che riportavano successo senza fare nulla. Un watchdog dei backup veniva OOM-killed a ogni run perché listava 8446 oggetti senza paginare, e una list fallita era indistinguibile da una vuota: stampava “tutto OK” ed usciva 0. Uno scraper di annunci hardware era rotto da 36 giorni perché l’upstream era passato a uno schema annidato e ogni get() restituiva il default, scartando silenziosamente il 100% dei candidati; un agent di sicurezza su un worker era Ready 2/2 con zero restart e non emetteva un evento da 12 giorni. La causa radice dei backup era più stupida e più istruttiva: un nodo al 98% di CPU richiesta contro l’8% reale rifiutava i pod che Velero pianifica bypassando lo scheduler — nodo praticamente idle, eppure saturo. Ho paginato le liste, messo i poteri distruttivi dietro flag di default OFF, aggiunto canary sul campo che filtra davvero (non su quello comodo da controllare) e un alert sulla saturazione delle request, che nessuna regola guardava. Adesso i backup completano — inclusa una schedule che non era mai riuscita una volta in vita sua — le metriche dello storage sono tornate dopo 76 giorni e la configurazione che viveva solo nel cluster è finita nel repo; resta onesto dirlo: metà delle regole ripristinate è severity=warning e il warning non sveglia nessuno.
grep -rl 'stesso filo' ~/lab
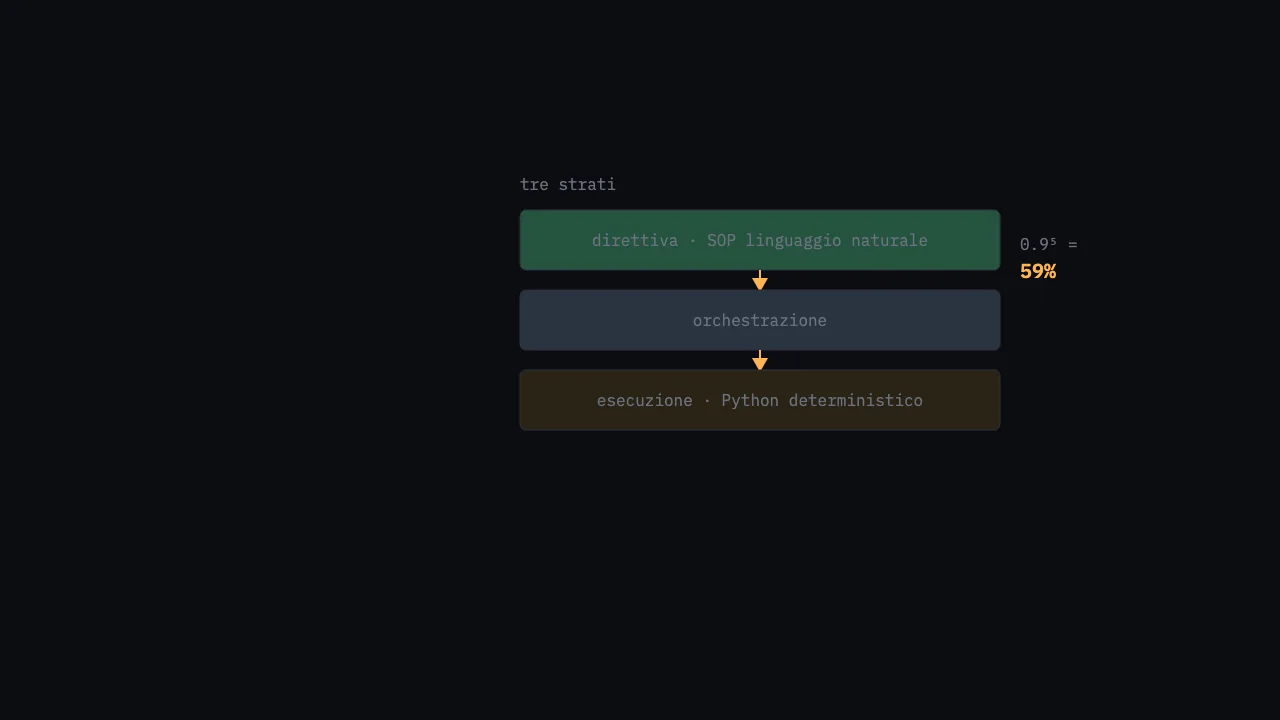
Il 59%: perché ho smesso di lasciar fare tutto all'LLM
Diario di uno scaffold multi-agente su Agno: tre strati direttiva/orchestrazione/esecuzione, SOP in linguaggio naturale sopra, Python deterministico sotto…
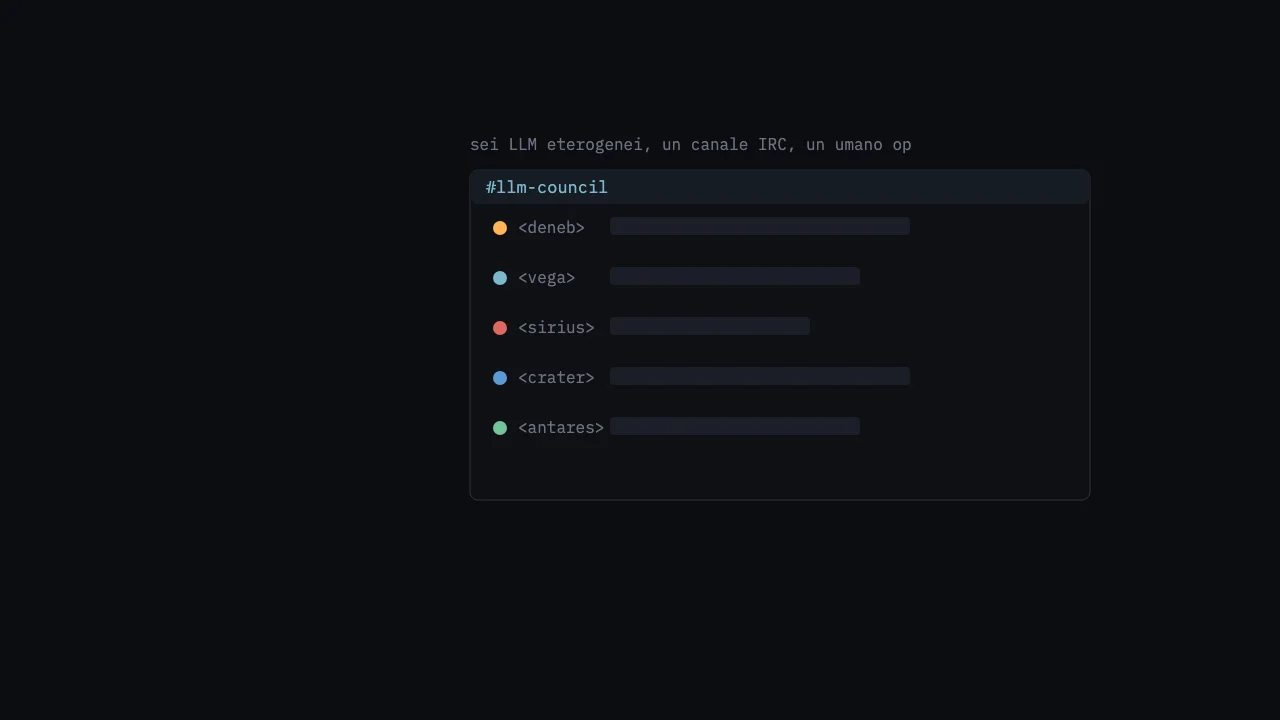
Sei LLM su un canale IRC privato, e l'unico op è un umano
Diario tecnico: più LLM eterogenei, ognuno su una postazione isolata, coordinati su un canale IRC privato. Il coordinamento non è nel prompt, è in IRC: modi…
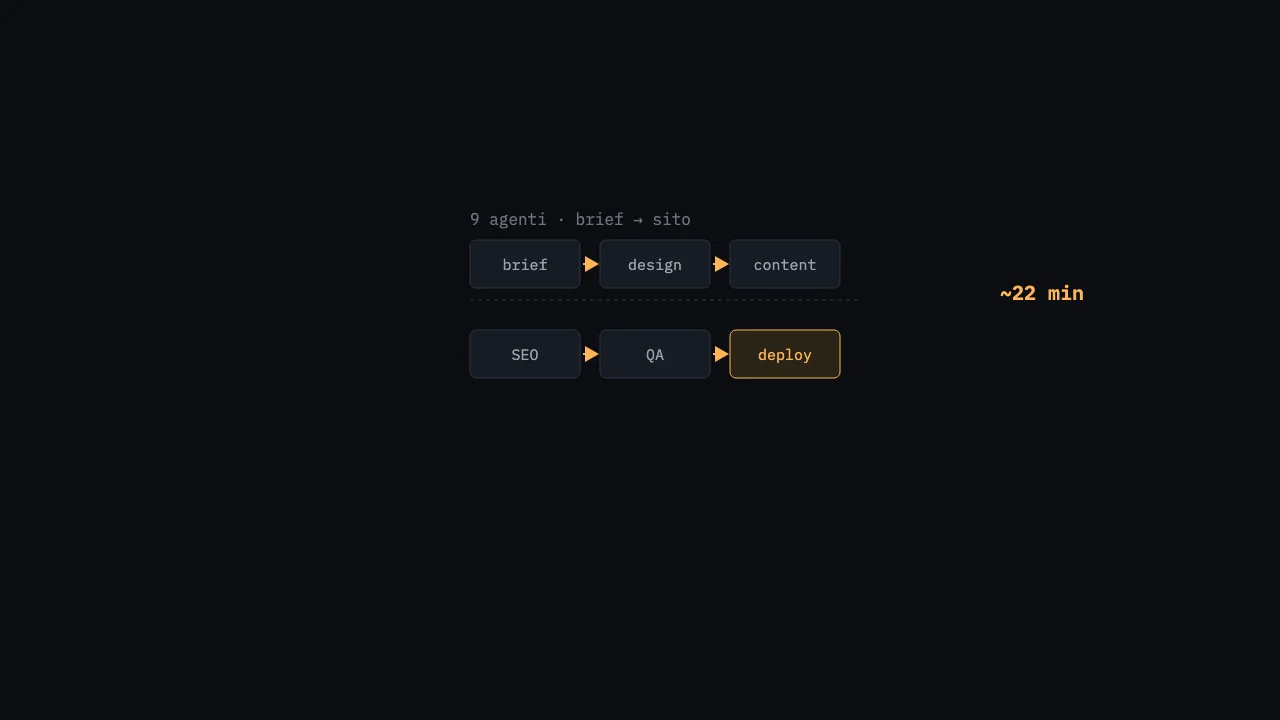
22 minuti per un sito WordPress, due giorni per non farlo sembrare brutto
Diario tecnico di un'agenzia web a 9 agenti Claude: dal brief al sito Divi 5 live in ~22 minuti su k8s bare-metal. La lezione: automatizzare la plumbing è…